
上下文缓存
| 项目 | 显式缓存 | 隐式缓存 |
|---|---|---|
| 是否影响回复效果 | 不影响 | 不影响 |
| 用于创建缓存Token计费 | 输入 Token 单价的125% | 输入 Token 单价的100% |
| 命中缓存的输入 Token 计费 | 输入 Token 单价的10% | 输入 Token 单价的20% |
| 缓存最少 Token 数 | 1024 | 256 |
| 缓存有效期 | 5分钟(命中后重置) | 不确定,系统会定期清理长期未使用的缓存数据 |
显式缓存
使用方式
"cache_control": {"type": "ephemeral"}标记,系统将以每个cache_control标记位置为终点,向前回溯最多 20 个 content 块,尝试命中缓存。单次请求最多支持加入4 个缓存标记。
cache_control标记之间的内容创建为新的缓存块,有效期为 5 分钟。缓存创建发生在模型响应之后,建议在创建请求完成后再尝试命中该缓存。
缓存块的内容最少为 1024 Token。
1.
[{"role": "system", "content": [{"type": "text", "text": A, "cache_control": {"type": "ephemeral"}}]}] 2.
[
    {"role": "system", "content": A},
    <其他 message>
    {"role": "user","content": [{"type": "text", "text": B, "cache_control": {"type": "ephemeral"}}]}
]支持的模型
中国内地
全球
、qwen-plus、qwen-flash国际
欧盟
快速开始
OpenAI 兼容
from openai import OpenAI
import os

client = OpenAI(
    # 若没有配置环境变量,请将下行替换为:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 以下是北京地域base_url,如果使用新加坡地域的模型,需要将base_url替换为:https://dashscope-intl.aliyuncs.com/compatible-mode/v1
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 模拟的代码仓库内容,最小可缓存提示词长度为 1024 Token
long_text_content = "<Your Code Here>" * 400

# 发起请求的函数
def get_completion(user_input):
    messages = [
        {
            "role": "system",
            "content": [
                {
                    "type": "text",
                    "text": long_text_content,
                    # 在此处放置 cache_control 标记,将创建从 messages 数组的开头到当前 content 所在位置的所有内容作为缓存块。
                    "cache_control": {"type": "ephemeral"},
                }
            ],
        },
        # 每次的提问内容不同
        {
            "role": "user",
            "content": user_input,
        },
    ]
    completion = client.chat.completions.create(
        # 选择支持显式缓存的模型
        model="qwen3-coder-plus",
        messages=messages,
    )
    return completion

# 第一次请求
first_completion = get_completion("这段代码的内容是什么")
print(f"第一次请求创建缓存 Token:{first_completion.usage.prompt_tokens_details.cache_creation_input_tokens}")
print(f"第一次请求命中缓存 Token:{first_completion.usage.prompt_tokens_details.cached_tokens}")
print("=" * 20)
# 第二次请求,代码内容一致,只修改了提问问题
second_completion = get_completion("这段代码可以怎么优化")
print(f"第二次请求创建缓存 Token:{second_completion.usage.prompt_tokens_details.cache_creation_input_tokens}")
print(f"第二次请求命中缓存 Token:{second_completion.usage.prompt_tokens_details.cached_tokens}")
DashScope
import os
from dashscope import Generation
# 若使用新加坡地域的模型,请释放下列注释
# dashscope.base_http_api_url = "https://dashscope-intl.aliyuncs.com/api/v1"

# 模拟的代码仓库内容,最小可缓存提示词长度为 1024 Token
long_text_content = "<Your Code Here>" * 400

# 发起请求的函数
def get_completion(user_input):
    messages = [
        {
            "role": "system",
            "content": [
                {
                    "type": "text",
                    "text": long_text_content,
                    # 在此处放置 cache_control 标记,将创建从 messages 数组的开头到当前 content 所在位置的所有内容作为缓存块。
                    "cache_control": {"type": "ephemeral"},
                }
            ],
        },
        # 每次的提问内容不同
        {
            "role": "user",
            "content": user_input,
        },
    ]
    response = Generation.call(
        # 若没有配置环境变量,请用阿里云百炼API Key将下行替换为:api_key = "sk-xxx",
        api_key=os.getenv("DASHSCOPE_API_KEY"),
        model="qwen3-coder-plus",
        messages=messages,
        result_format="message"
    )
    return response

# 第一次请求
first_completion = get_completion("这段代码的内容是什么")
print(f"第一次请求创建缓存 Token:{first_completion.usage.prompt_tokens_details['cache_creation_input_tokens']}")
print(f"第一次请求命中缓存 Token:{first_completion.usage.prompt_tokens_details['cached_tokens']}")
print("=" * 20)
# 第二次请求,代码内容一致,只修改了提问问题
second_completion = get_completion("这段代码可以怎么优化")
print(f"第二次请求创建缓存 Token:{second_completion.usage.prompt_tokens_details['cache_creation_input_tokens']}")
print(f"第二次请求命中缓存 Token:{second_completion.usage.prompt_tokens_details['cached_tokens']}")// Java SDK 最低版本为 2.21.6
import com.alibaba.dashscope.aigc.generation.Generation;
import com.alibaba.dashscope.aigc.generation.GenerationParam;
import com.alibaba.dashscope.aigc.generation.GenerationResult;
import com.alibaba.dashscope.common.Message;
import com.alibaba.dashscope.common.MessageContentText;
import com.alibaba.dashscope.common.Role;
import com.alibaba.dashscope.exception.ApiException;
import com.alibaba.dashscope.exception.InputRequiredException;
import com.alibaba.dashscope.exception.NoApiKeyException;
import java.util.Arrays;
import java.util.Collections;
public class Main {
private static final String MODEL = "qwen3-coder-plus";
// 模拟代码仓库内容(400次重复确保超过1024 Token)
private static final String LONG_TEXT_CONTENT = generateLongText(400);
private static String generateLongText(int repeatCount) {
StringBuilder sb = new StringBuilder();
for (int i = 0; i < repeatCount; i++) {
sb.append("<Your Code Here>");
}
return sb.toString();
}
private static GenerationResult getCompletion(String userQuestion)
throws NoApiKeyException, ApiException, InputRequiredException {
// 若使用新加坡地域模型,请将 https://dashscope.aliyuncs.com/api/v1 修改为 https://dashscope-intl.aliyuncs.com/api/v1
Generation gen = new Generation("http", "https://dashscope.aliyuncs.com/api/v1");
// 构建带缓存控制的系统消息
MessageContentText systemContent = MessageContentText.builder()
.type("text")
.text(LONG_TEXT_CONTENT)
.cacheControl(MessageContentText.CacheControl.builder()
.type("ephemeral") // 设置缓存类型
.build())
.build();
Message systemMsg = Message.builder()
.role(Role.SYSTEM.getValue())
.contents(Collections.singletonList(systemContent))
.build();
Message userMsg = Message.builder()
.role(Role.USER.getValue())
.content(userQuestion)
.build();
// 构建请求参数
GenerationParam param = GenerationParam.builder()
.model(MODEL)
.messages(Arrays.asList(systemMsg, userMsg))
.resultFormat(GenerationParam.ResultFormat.MESSAGE)
.build();
return gen.call(param);
}
private static void printCacheInfo(GenerationResult result, String requestLabel) {
System.out.printf("%s创建缓存 Token: %d%n", requestLabel, result.getUsage().getPromptTokensDetails().getCacheCreationInputTokens());
System.out.printf("%s命中缓存 Token: %d%n", requestLabel, result.getUsage().getPromptTokensDetails().getCachedTokens());
}
public static void main(String[] args) {
try {
// 第一次请求
GenerationResult firstResult = getCompletion("这段代码的内容是什么");
printCacheInfo(firstResult, "第一次请求");
System.out.println(new String(new char[20]).replace('\0', '=')); // 第二次请求
GenerationResult secondResult = getCompletion("这段代码可以怎么优化");
printCacheInfo(secondResult, "第二次请求");
} catch (NoApiKeyException | ApiException | InputRequiredException e) {
System.err.println("API调用失败: " + e.getMessage());
e.printStackTrace();
}
}
}Anthropic 兼容
import anthropic
import os

client = anthropic.Anthropic(
    # 若没有配置环境变量,请将下行替换为:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 以下是北京地域base_url,如果使用新加坡地域的模型,需要将base_url替换为:https://dashscope-intl.aliyuncs.com/apps/anthropic
    base_url="https://dashscope.aliyuncs.com/apps/anthropic",
)

# 模拟的代码仓库内容,最小可缓存提示词长度为 1024 Token
long_text_content = "<Your Code Here>" * 400

# 发起请求的函数
def get_completion(user_input):
    response = client.messages.create(
        # 选择支持显式缓存的模型
        model="qwen3-coder-plus",
        max_tokens=1024,
        system=[
            {
                "type": "text",
                "text": long_text_content,
                # 在此处放置 cache_control 标记,将创建 system text内容作为缓存块,也可放置在messages消息中
                "cache_control": {"type": "ephemeral"},
            }
        ],
        messages=[
            # 每次的提问内容不同
            {"role": "user", "content": user_input},
        ],
    )
    return response

# 第一次请求
first_completion = get_completion("这段代码的内容是什么")
print(f"第一次请求创建缓存 Token:{first_completion.usage.cache_creation_input_tokens}")
print(f"第一次请求命中缓存 Token:{first_completion.usage.cache_read_input_tokens}")
print("=" * 20)
# 第二次请求,代码内容一致,只修改了提问问题
second_completion = get_completion("这段代码可以怎么优化")
print(f"第二次请求创建缓存 Token:{second_completion.usage.cache_creation_input_tokens}")
print(f"第二次请求命中缓存 Token:{second_completion.usage.cache_read_input_tokens}")cache_control标记启用显式缓存。后续针对该代码仓库的提问请求,系统可复用该缓存块,无需重新计算,可获得比创建缓存前更快的响应与更低的成本。第一次请求创建缓存 Token:1605
第一次请求命中缓存 Token:0
====================
第二次请求创建缓存 Token:0
第二次请求命中缓存 Token:1605使用多个缓存标记实现精细控制
如何计费
创建缓存所用的 Token数通过 cache_creation_input_tokens参数查看。
命中缓存的 Token数通过 cached_tokens参数查看。
可缓存内容
messages 数组中的以下消息类型支持添加缓存标记:tools 参数(Function Calling 场景),工具定义会作为系统消息的一部分参与缓存计算。工具定义不支持独立缓存,在工具定义中添加缓存标记会被忽略,缓存标记只能添加在 messages 的 content 中。使用 qwen3-vl-plus模型创建缓存时,cache_control标记可放置在多模态内容或文本之后,其位置不影响缓存整个用户消息的效果。
content 字段改为数组形式,并添加 cache_control 字段:{
"role": "system",
"content": [
{
"type": "text",
"text": "<指定的提示词>",
"cache_control": {
"type": "ephemeral"
}
}
]
}messages 数组中的其他消息类型。缓存限制
cache_control 标记的消息之间间隔超过 20 个 content 块,则无法命中缓存。type 设置为 ephemeral,有效期为 5 分钟。若缓存标记个数大于4,则最后四个缓存标记生效。
提高 Function Calling 缓存命中率
使用示例
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    # 以下为中国内地(北京)base_url,国际(新加坡)base_url为https://dashscope-intl.aliyuncs.com/compatible-mode/v1
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

# 模拟的代码仓库内容
long_text_content = "<Your Code Here>" * 400

# 发起请求的函数
def get_completion(user_input):
    messages = [
        {
            "role": "system",
            "content": [
                {
                    "type": "text",
                    "text": long_text_content,
                    # 在此处放置 cache_control 标记,将创建从messages数组开始,到本content结束位置(即模拟的代码仓库内容)的缓存。
                    "cache_control": {"type": "ephemeral"},
                }
            ],
        },
        {
            "role": "user",
            "content": user_input,
        },
    ]
    completion = client.chat.completions.create(
        # 选择支持显式缓存的模型
        model="qwen3-coder-plus",
        messages=messages,
    )
    return completion

# 第一次请求
first_completion = get_completion("这段代码的内容是什么")
created_cache_tokens = first_completion.usage.prompt_tokens_details.cache_creation_input_tokens
print(f"第一次请求创建缓存 Token:{created_cache_tokens}")
hit_cached_tokens = first_completion.usage.prompt_tokens_details.cached_tokens
print(f"第一次请求命中缓存 Token:{hit_cached_tokens}")
print(f"第一次请求未命中也未创建缓存的 Token:{first_completion.usage.prompt_tokens-created_cache_tokens-hit_cached_tokens}")
print("=" * 20)
# 第二次请求,代码内容一致,只修改了提问问题
second_completion = get_completion("这段代码有哪些可以优化的地方")
created_cache_tokens = second_completion.usage.prompt_tokens_details.cache_creation_input_tokens
print(f"第二次请求创建缓存 Token:{created_cache_tokens}")
hit_cached_tokens = second_completion.usage.prompt_tokens_details.cached_tokens
print(f"第二次请求命中缓存 Token:{hit_cached_tokens}")
print(f"第二次请求未命中也未创建缓存的 Token:{second_completion.usage.prompt_tokens-created_cache_tokens-hit_cached_tokens}")第一次请求创建缓存 Token:1605
第一次请求命中缓存 Token:0
第一次请求未命中也未创建缓存的 Token:13
====================
第二次请求创建缓存 Token:0
第二次请求命中缓存 Token:1605
第二次请求未命中也未创建缓存的 Token:15系统为保证模型效果,会追加少量内部Token,这部分Token按标准输入价格计费,请参见常见问题。
tools 参数会作为系统消息的一部分参与缓存。需确保每次请求的工具定义完全一致(包括工具顺序、字段顺序、字段结构),并在 messages 的最后一个 content 上添加 cache_control 标记。from openai import OpenAI
import os
client = OpenAI(
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
# 模拟的代码仓库内容,确保超过显式缓存最小 1024 Token 阈值
long_text_content = "<Your Code Here>" * 400
# 工具定义:确保每次请求完全一致(工具顺序、字段顺序、字段结构)
tools = [
{
"type": "function",
"function": {
"name": "get_weather",
"description": "查询指定城市的当前天气信息",
"parameters": {
"type": "object",
"properties": {
"city": {
"type": "string",
"description": "城市名称,如北京、上海、纽约等"
},
"unit": {
"type": "string",
"description": "温度单位,celsius(摄氏度)或 fahrenheit(华氏度),默认为 celsius",
"enum": ["celsius", "fahrenheit"]
}
},
"required": ["city"],
"additionalProperties": False
},
"strict": True
}
},
{
"type": "function",
"function": {
"name": "get_current_time",
"description": "查询指定时区的当前日期和时间",
"parameters": {
"type": "object",
"properties": {
"timezone": {
"type": "string",
"description": "IANA 时区名称,如 Asia/Shanghai、America/New_York 等,默认为 Asia/Shanghai"
}
},
"required": [],
"additionalProperties": False
},
"strict": True
}
},
{
"type": "function",
"function": {
"name": "convert_currency",
"description": "按照实时汇率进行货币金额的单位转换",
"parameters": {
"type": "object",
"properties": {
"from_currency": {
"type": "string",
"description": "源货币的 ISO 4217 代码,如 CNY、USD、EUR 等"
},
"to_currency": {
"type": "string",
"description": "目标货币的 ISO 4217 代码"
},
"amount": {
"type": "number",
"description": "需要转换的金额"
}
},
"required": ["from_currency", "to_currency", "amount"],
"additionalProperties": False
},
"strict": True
}
}
]
def get_completion(user_input, messages=None):
if messages is None:
messages = [
{
"role": "system",
"content": [
{
"type": "text",
"text": long_text_content,
# 在此处放置 cache_control 标记,将创建从 messages 数组的开头到当前 content 所在位置的所有内容作为缓存块。
# cache_control 只能加在 messages 的 content 上,不能加在 tools 上
"cache_control": {"type": "ephemeral"},
}
],
}
]
messages.append({"role": "user", "content": user_input})
completion = client.chat.completions.create(
# 选择支持显式缓存的模型
model="qwen3.6-plus",
messages=messages,
tools=tools,
# 关闭深度思考模式
extra_body={"enable_thinking": False},
)
return completion
# 第一次请求:创建缓存
print("=== 第一次请求(创建缓存)===")
first_completion = get_completion("北京现在天气怎么样?")
usage = first_completion.usage
print(f"Prompt Tokens: {usage.prompt_tokens}")
print(f"创建缓存 Token: {usage.prompt_tokens_details.cache_creation_input_tokens}")
print(f"命中缓存 Token: {usage.prompt_tokens_details.cached_tokens}")
print(f"模型选择了工具: {[t.function.name for t in first_completion.choices[0].message.tool_calls or []]}")
print()
# 第二次请求:相同 system message,只修改提问内容,命中缓存
print("=== 第二次请求(命中缓存)===")
messages = [
{
"role": "system",
"content": [
{
"type": "text",
"text": long_text_content,
"cache_control": {"type": "ephemeral"},
}
],
}
]
second_completion = get_completion("上海现在天气怎么样?", messages=messages)
usage = second_completion.usage
print(f"Prompt Tokens: {usage.prompt_tokens}")
print(f"创建缓存 Token: {usage.prompt_tokens_details.cache_creation_input_tokens}")
print(f"命中缓存 Token: {usage.prompt_tokens_details.cached_tokens}")
print(f"模型选择了工具: {[t.function.name for t in second_completion.choices[0].message.tool_calls or []]}")=== 第一次请求(创建缓存)===
Prompt Tokens: 2174
创建缓存 Token: 2156
命中缓存 Token: 0
模型选择了工具: ['get_weather']
=== 第二次请求(命中缓存)===
Prompt Tokens: 2174
创建缓存 Token: 0
命中缓存 Token: 2156
模型选择了工具: ['get_weather']from openai import OpenAI
import os
client = OpenAI(
api_key=os.getenv("DASHSCOPE_API_KEY"),
# 以下为中国内地(北京)base_url,国际(新加坡)base_url为https://dashscope-intl.aliyuncs.com/compatible-mode/v1
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
system_prompt = "你是说话风趣的人。" * 400
messages = [{"role": "system", "content": system_prompt}]
def get_completion(messages):
completion = client.chat.completions.create(
model="qwen3-coder-plus",
messages=messages,
)
return completion
while True:
user_input = input("请输入:")
messages.append({"role": "user", "content": [{"type": "text", "text": user_input, "cache_control": {"type": "ephemeral"}}]})
completion = get_completion(messages)
print(f"[AI Response] {completion.choices[0].message.content}")
messages.append(completion.choices[0].message)
created_cache_tokens = completion.usage.prompt_tokens_details.cache_creation_input_tokens
hit_cached_tokens = completion.usage.prompt_tokens_details.cached_tokens
uncached_tokens = completion.usage.prompt_tokens - created_cache_tokens - hit_cached_tokens
print(f"[Cache Info] 创建缓存 Token:{created_cache_tokens}")
print(f"[Cache Info] 命中缓存 Token:{hit_cached_tokens}")
print(f"[Cache Info] 未命中也未创建缓存的 Token:{uncached_tokens}")隐式缓存
支持的模型
中国内地
全球
国际
美国
欧盟
工作方式
1.
messages 数组内容的公共前缀。2.
系统会定期清理长期未使用的缓存数据。上下文缓存命中概率并非100%,即使请求上下文完全一致,仍可能未命中,具体命中概率由系统判定。
提升命中缓存的概率
如何计费
cached_token 计费,折扣比例因模型来源不同而有差异;未被命中的输入 Token 按标准 input_token计费。输出 Token 仍按原价计费。cached_token 单价为 input_token 单价的 20%cached_token 单价不是 input_token 单价的 20%,具体价格请参见百炼控制台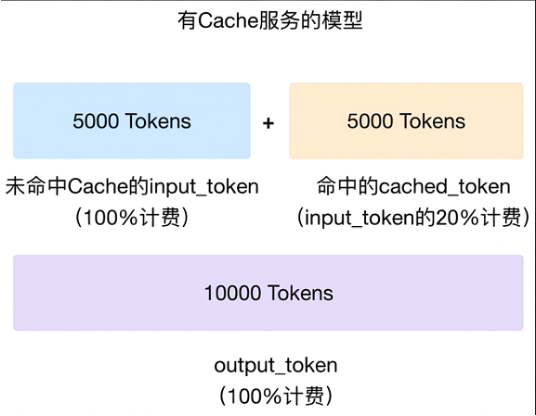
cached_tokens属性获取命中缓存的 Token 数。OpenAI兼容-Batch(文件输入)方式调用无法享受缓存折扣。
命中缓存的案例
文本生成模型
OpenAI兼容
usage.prompt_tokens_details.cached_tokens可以查看命中缓存的 Token 数(该数值为usage.prompt_tokens的一部分)。{
"choices": [
{
"message": {
"role": "assistant",
"content": "我是阿里云开发的一款超大规模语言模型,我叫千问。"
},
"finish_reason": "stop",
"index": 0,
"logprobs": null
}
],
"object": "chat.completion",
"usage": {
"prompt_tokens": 3019,
"completion_tokens": 104,
"total_tokens": 3123,
"prompt_tokens_details": {
"cached_tokens": 2048
}
},
"created": 1735120033,
"system_fingerprint": null,
"model": "qwen-plus",
"id": "chatcmpl-6ada9ed2-7f33-9de2-8bb0-78bd4035025a"
}DashScope
usage.prompt_tokens_details.cached_tokens可以查看命中缓存的 Token 数(该数值是 usage.input_tokens 的一部分。)。{
"status_code": 200,
"request_id": "f3acaa33-e248-97bb-96d5-cbeed34699e1",
"code": "",
"message": "",
"output": {
"text": null,
"finish_reason": null,
"choices": [
{
"finish_reason": "stop",
"message": {
"role": "assistant",
"content": "我是一个来自阿里云的大规模语言模型,我叫千问。我可以生成各种类型的文本,如文章、故事、诗歌、故事等,并能够根据不同的场景和需求进行变换和扩展。此外,我还能够回答各种问题,提供帮助和解决方案。如果您有任何问题或需要帮助,请随时告诉我,我会尽力提供支持。请注意,连续重复相同的内容可能无法获得更详细的答复,建议您提供更多具体信息或变化提问方式以便我更好地理解您的需求。"
}
}
]
},
"usage": {
"input_tokens": 3019,
"output_tokens": 101,
"prompt_tokens_details": {
"cached_tokens": 2048
},
"total_tokens": 3120
}
}Anthropic 兼容
usage.cache_read_input_tokens 查看(该数值不计入 usage.input_tokens,而是单独报告)。{
"id": "msg_01XFDUDYJgAACzvnptvVoYEL",
"type": "message",
"role": "assistant",
"content": [
{
"type": "text",
"text": "这段内容是重复的占位文本"
}
],
"model": "qwen3-coder-plus",
"stop_reason": "end_turn",
"usage": {
"input_tokens": 82,
"cache_creation_input_tokens": 0,
"cache_read_input_tokens": 1536,
"output_tokens": 14
}
}视觉理解模型
OpenAI兼容
usage.prompt_tokens_details.cached_tokens可以查看命中缓存的 Token 数(该 Token 数是usage.prompt_tokens的一部分)。{
"id": "chatcmpl-3f3bf7d0-b168-9637-a245-dd0f946c700f",
"choices": [
{
"finish_reason": "stop",
"index": 0,
"logprobs": null,
"message": {
"content": "这张图像展示了一位女性和一只狗在海滩上互动的温馨场景。女性穿着格子衬衫,坐在沙滩上,面带微笑地与狗进行互动。狗是一只大型的浅色犬种,戴着彩色的项圈,前爪抬起,似乎在与女性握手或击掌。背景是广阔的海洋和天空,阳光从画面的右侧照射过来,给整个场景增添了一种温暖而宁静的氛围。",
"refusal": null,
"role": "assistant",
"audio": null,
"function_call": null,
"tool_calls": null
}
}
],
"created": 1744956927,
"model": "qwen-vl-max",
"object": "chat.completion",
"service_tier": null,
"system_fingerprint": null,
"usage": {
"completion_tokens": 93,
"prompt_tokens": 1316,
"total_tokens": 1409,
"completion_tokens_details": null,
"prompt_tokens_details": {
"audio_tokens": null,
"cached_tokens": 1152
}
}
}DashScope
qwen-vl-max、qwen-vl-plus:在usage.prompt_tokens_details.cached_tokens查看 qwen3-vl-plus、qwen3-vl-flash:在 usage.prompt_tokens_details.cached_tokens查看 usage.cached_tokens目前使用 usage.cached_tokens的模型,后续将升级至usage.prompt_tokens_details.cached_tokens。
{
  "status_code": 200,
  "request_id": "06a8f3bb-d871-9db4-857d-2c6eeac819bc",
  "code": "",
  "message": "",
  "output": {
    "text": null,
    "finish_reason": null,
    "choices": [
      {
        "finish_reason": "stop",
        "message": {
          "role": "assistant",
          "content": [
            {
              "text": "这张图像展示了一位女性和一只狗在海滩上互动的温馨场景。女性穿着格子衬衫,坐在沙滩上,面带微笑地与狗进行互动。狗是一只大型犬,戴着彩色项圈,前爪抬起,似乎在与女性握手或击掌。背景是广阔的海洋和天空,阳光从画面右侧照射过来,给整个场景增添了一种温暖而宁静的氛围。"
            }
          ]
        }
      }
    ]
  },
  "usage": {
    "input_tokens": 1292,
    "output_tokens": 87,
    "input_tokens_details": {
      "text_tokens": 43,
      "image_tokens": 1249
    },
    "total_tokens": 1379,
    "output_tokens_details": {
      "text_tokens": 87
    },
    "image_tokens": 1249,
    "prompt_tokens_details": {
      "cached_tokens": 1152
    }
  }
}
Anthropic 兼容
usage.cache_read_input_tokens 字段中(与文本生成模型一致)。{
"id": "msg_01XFDUDYJgAACzvnptvVoYEL",
"type": "message",
"role": "assistant",
"content": [
{
"type": "text",
"text": "这张图片展示了一位女性和一只狗在海滩上互动的温馨场景。"
}
],
"model": "qwen-vl-max",
"stop_reason": "end_turn",
"usage": {
"input_tokens": 369,
"cache_creation_input_tokens": 0,
"cache_read_input_tokens": 896,
"output_tokens": 28
}
}典型场景
1.
messages = [{"role": "system","content": "你是一个语文老师,你可以帮助学生进行阅读理解。"},
{"role": "user","content": "<文章内容> 这篇课文表达了作者怎样的思想感情?"}]messages = [{"role": "system","content": "你是一个语文老师,你可以帮助学生进行阅读理解。"},
{"role": "user","content": "<文章内容> 请赏析这篇课文的第三自然段。"}]2.
3.
messages=[{"role": "system","content": "You are a helpful assistant."},
{"role": "user","content": "你是谁?"}]messages=[{"role": "system","content": "You are a helpful assistant."},
{"role": "user","content": "你是谁?"},
{"role": "assistant","content": "我是由阿里云开发的千问。"},
{"role": "user","content": "你能干什么?"}]4.
system_prompt = """你是一位经验丰富的营销专家。请针对不同产品提供详细的营销建议,格式如下:

1. 目标受众:xxx

2. 主要卖点:xxx

3. 营销渠道:xxx
...
12. 长期发展策略:xxx

请确保你的建议具体、可操作,并与产品特性高度相关。"""

# 第一次请求的user message 提问关于智能手表
messages_1=[
  {"role": "system", "content": system_prompt},
  {"role": "user", "content": "请为一款新上市的智能手表提供营销建议。"}
]

# 第二次请求的user message 提问关于笔记本电脑,由于system_prompt相同,有较大概率命中 Cache
messages_2=[
  {"role": "system", "content": system_prompt},
  {"role": "user", "content": "请为一款新上市的笔记本电脑提供营销建议。"}
]5.
video放在text前会提高命中缓存的概率;如果对不同的视频提问相同的问题,则将text放在video前面,会提高命中缓存的概率。以下是对同一个视频请求两次的消息示例:# 第一次请求的user message 提问这段视频的内容
messages1 = [
{"role":"system","content":[{"text": "You are a helpful assistant."}]},
{"role": "user",
"content": [
{"video": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250328/eepdcq/phase_change_480p.mov"},
{"text": "这段视频的内容是什么?"}
]
}
]
# 第二次请求的user message 提问关于视频时间戳相关的问题,由于基于同一个视频进行提问,将video放在text前面,有较大概率命中 Cache
messages2 = [
{"role":"system","content":[{"text": "You are a helpful assistant."}]},
{"role": "user",
"content": [
{"video": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20250328/eepdcq/phase_change_480p.mov"},
{"text": "请你描述下视频中的一系列活动事件,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event),不要输出```json```代码段"}
]
}
]常见问题
Q:如何关闭隐式缓存?
Q:为什么创建显式缓存后没有命中?
content与已存在的缓存块的间隔大于20个content块时,不会命中缓存,建议创建新的缓存块。Q:显式缓存命中后,是否会重置有效期?
Q:不同账号之间的显式缓存是否会共享?
**Q:**相同账号使用不同模型显式缓存是否会共享?
Q:为什么**usage**的**input_tokens**不等于**cache_creation_input_tokens**和**cached_tokens**的总和?
cache_control 标记之后,因此不会被计入缓存的创建或读取,但会计入总的 input_tokens。修改于 2026-07-27 00:40:27